文字数がツールやサービスによって違う理由と、合わせ方
同じ文章でも文字数が合わないのは、数える単位と空白・改行の扱いが違うためです。絵文字、全角文字、改行で差が出る理由と、提出先の数え方に合わせる手順を解説します。
公開日 更新日
同じ文章なのに文字数が違う理由
文字数が合わないのは、ツールやサービスによって「何を1と数えるか」が違うためです。違いは次の3つのどれかです。
- 数える単位が違う(見た目の1文字、コードポイント、UTF-16のコード単位、バイト)
- 空白と改行を数えるかどうかが違う
- 文字の種類によって重みを変えている(全角を2と数える、など)
英数字、ひらがな、よく使われる漢字だけの1行の文章なら、バイト数や重み付きの数え方を除いて、どの数え方でも同じ値になります。差が出るのは、絵文字、一部の漢字、濁点が分かれた文字、空白、改行が入っているときです。どれが正しいということはなく、文章を出す先の数え方に合わせる必要があります。
数える単位は4つある
コンピューターは文字を数値の並びとして保存します。その並びのどの段階で数えるかによって、同じ文字でも値が変わります。
- 書記素(見た目の1文字): 人が1文字と認識するまとまりです。複数の符号をつないだ絵文字も1と数えます
- コードポイント: Unicodeが文字や部品に割り当てた番号の数です。つないだ絵文字は、部品の数だけ増えます
- UTF-16のコード単位: JavaScriptの
"文字列".lengthや、HTMLの入力欄のmaxlengthが数える単位です。😀のような多くの絵文字と一部の漢字は、1つのコードポイントが2になります - UTF-8のバイト数: ファイルや通信で使われる大きさです。半角の英数字は1、ひらがな・漢字の多くは3、
😀のような1つのコードポイントの絵文字の多くは4になります。つないだ絵文字は、部品のぶんだけ増えます
同じ文字を4つの単位で数えた結果です。値は順に、書記素 / コードポイント / UTF-16のコード単位 / UTF-8のバイト数です。
a: 1 / 1 / 1 / 1あ: 1 / 1 / 1 / 3𠮷(「吉」の異体字): 1 / 1 / 2 / 4😀: 1 / 1 / 2 / 4🇯🇵: 1 / 2 / 4 / 8👨👩👧👦: 1 / 7 / 11 / 25- 「か」と濁点の符号(U+3099)に分けて保存された「が」: 1 / 2 / 2 / 6
最後の例は、見た目が同じ「が」でも、1つの符号で保存されている場合(1 / 1 / 1 / 3)と、「か」に濁点の符号を足して保存されている場合があることを示しています。macOSのファイル名からコピーした文字などで、後者になることがあります。見た目では区別できないため、数だけが合わない原因になります。
空白と改行の扱い
単位が同じでも、空白と改行の扱いで値が変わります。
- 空白を数えるか: 半角空白、全角空白、タブを文字数に含めるかどうかは、ツールごとに違います。「スペースを含める」と「スペースを含めない」の両方を表示するものもあります
- 改行を数えるか: 改行を1文字と数えるツールと、数えないツールがあります。Microsoft Wordの文字カウントは、改行(段落記号)を文字数に含めません
- 改行が1か2か: 改行はLF(1つの符号)の場合と、CRLF(2つの符号)の場合があります。ブラウザーの複数行の入力欄は、画面上では改行を1つとして扱いますが、HTMLのフォームとしてそのまま送信するときにはCRLFに直します。送信先のサーバーが受け取った文字列をそのまま数えると、画面で見た値より改行の数だけ多くなることがあります。JavaScriptで入力欄の値を取り出して送るページでは、改行は1つのままです
- 末尾の空白や改行: 送信時に前後の空白を取り除いてから数えるサービスもあります
改行を30個含む文章なら、改行を数えるかどうかだけで30文字の差が出ます。原稿やレポートで文字数が大きくずれるときは、まず改行と空白を疑ってください。
文字の種類で重みを変える数え方
文字の種類ごとに重みを決めて、合計を上限と比べるサービスもあります。
- X(旧Twitter): 通常の投稿の上限は280ですが、日本語などのCJK文字と絵文字は1文字を2と数えます。日本語だけの投稿は140文字までです(有料プランの長文投稿は上限が別です)。URLは長さに関係なく23と数えます。つないだ絵文字も、部品の数に関係なく2です
- 全角を2、半角を1と数えるフォーム: Shift_JISのように全角文字を2バイトで保存する文字コードのバイト数に由来する数え方です。「全角◯文字(半角◯文字)以内」と書かれている入力欄はこの数え方です
- バイト数で制限するもの: データベースの列やファイル名の長さなどです。UTF-8では日本語の1文字が3バイトになることが多いため、「255バイトまで」は日本語でおよそ85文字までを意味します
これらの上限は、見た目の文字数とは一致しません。重みを付けた値やバイト数を表示するツールで確かめる必要があります。
提出先の数え方に合わせる手順
- 提出先の指定を読みます。「空白・改行を含む」「全角◯文字」「◯バイト以内」のような書き方から、単位と、空白・改行の扱いが分かります
- 指定が書かれていない場合は、短い文章で確かめます。
あ😀と入力して、提出先の画面の値が2なら見た目の文字数かコードポイント、3ならUTF-16のコード単位、4なら全角や絵文字を2とする重み付き、7ならUTF-8のバイト数である可能性が高いです。2だった場合は、続けてあ🇯🇵を入力します。2のままなら見た目の文字数、3ならコードポイントです - 続けて、
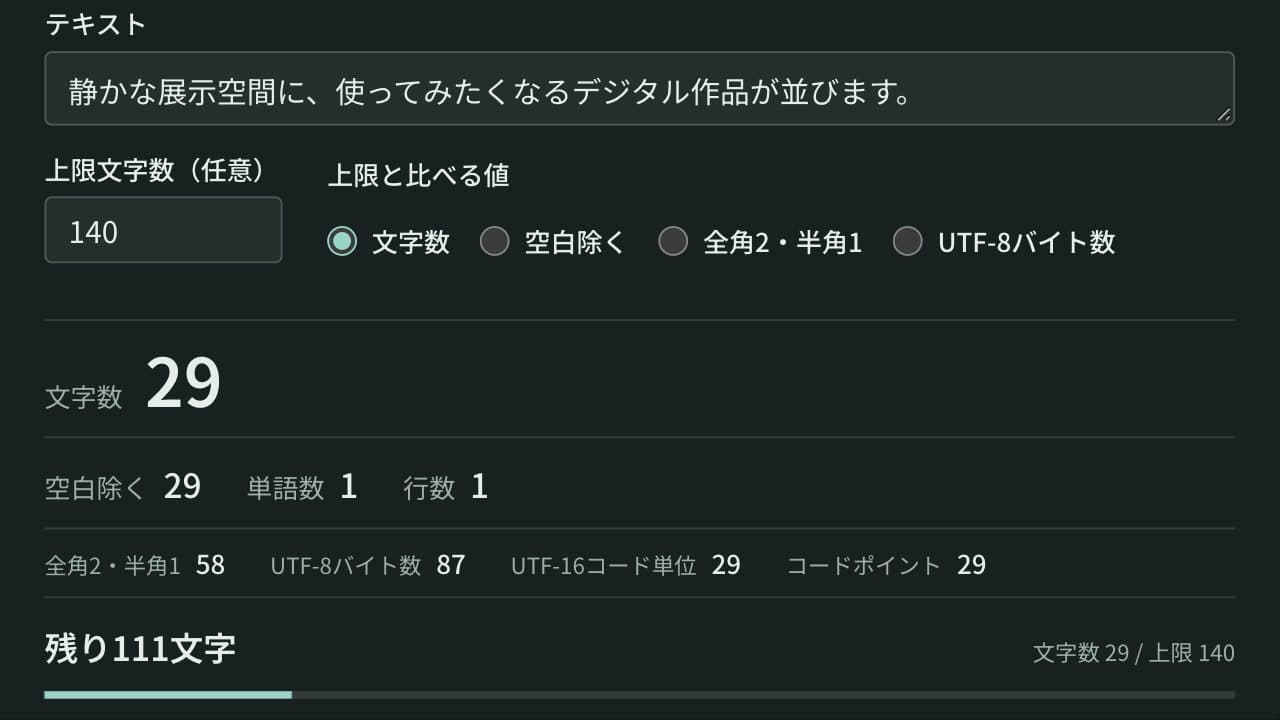
あいと、「あ」と「い」の間に改行を1つ入れたものを比べます。値が同じなら、改行は数えられていません。文の途中の改行で確かめるのは、末尾の改行だけを取り除いてから数えるサービスがあるためです - 見た目の文字数で数える提出先なら(コードポイントで数える提出先でも、国旗やつないだ絵文字を使わなければ同じ値になります)、文字数カウントツールで数えます。このアプリは書記素の単位で数え、「文字数」は空白と改行を含めた値、「空白除く」は空白と改行を除いた値です。提出先の指定に合うほうを読みます
- 全角を2・半角を1と数える提出先、UTF-8のバイト数やUTF-16のコード単位、コードポイントで数える提出先では、同じアプリの下の行に並ぶ「全角2・半角1」「UTF-8バイト数」「UTF-16コード単位」「コードポイント」を読みます。「全角2・半角1」は符号ごとに数えるため、つないだ絵文字やURLを含む文章では、Xの数え方とは一致しません
- 上限が決まっている場合は、アプリの「上限文字数(任意)」に数字を入れ、「上限と比べる値」を提出先と同じ基準にすると、残りが表示されます。選べる基準は「文字数」「空白除く」「全角2・半角1」「UTF-8バイト数」です
- 改行をCRLFとして数える提出先や、全角・半角の分け方が独自の提出先では、アプリの値は目安にとどめ、最後は提出先の画面に表示される値で確認します
上限ぎりぎりまで書く場合は、どの数え方でも値が変わらない文字だけにすると安全です。絵文字や、機種によって見た目が変わる記号を避けると、数え方の差の影響を受けにくくなります。
JavaScriptで確かめる
ブラウザーの開発者ツールのコンソールで、4つの単位をそれぞれ確かめられます。
const text = "あ😀";

text.length;
// UTF-16のコード単位: 3

[...text].length;
// コードポイント: 2

[...new Intl.Segmenter("ja", { granularity: "grapheme" }).segment(text)].length;
// 書記素: 2

new TextEncoder().encode(text).length;
// UTF-8のバイト数: 7
text.length で上限を判定しているフォームでは、多くの絵文字が1つで2文字以上を使います。自分で入力欄を作る場合は、利用者に見せる残りの文字数と、上限の判定に同じ単位を使ってください。
参考資料
このガイドで使えるアプリ
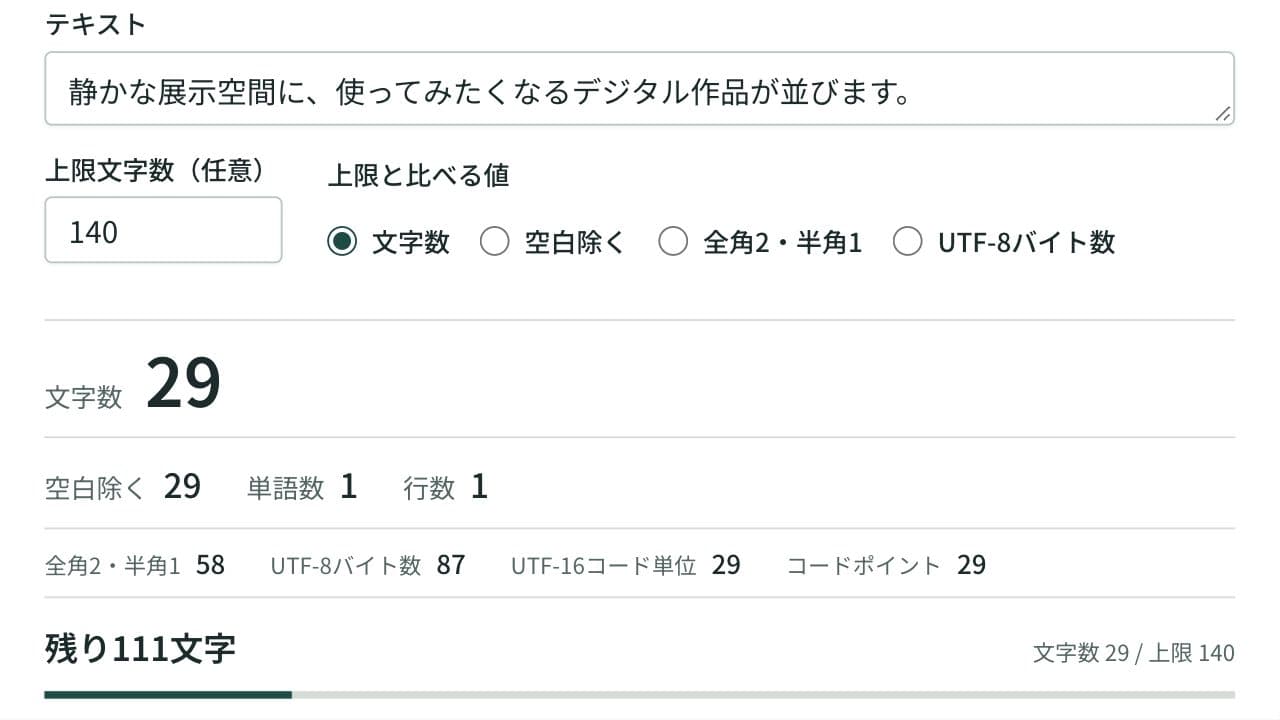
文字数カウントツール
文字数・単語数・行数をリアルタイムでカウント。全角を2・半角を1とする数え方、UTF-8のバイト数、UTF-16のコード単位も表示し、上限までの残りと、上限を超えた位置が分かります。SNS投稿や原稿、入力フォームの文字数チェックに。